Anthropic 에 이어 OpenAI 까지? AI Agent 시대를 위해 새롭게 설계한 Git 시스템, Pando
AI 가 소프트웨어 개발 방식을 바꾸고 있다.
과거에는 개발자가 직접 코드를 작성하고, 테스트하고, Git Repository 에 Push 하는 과정이 일반적이었다. 하지만 Codex 와 같은 AI Agent 가 등장하면서 한 명의 개발자가 여러 작업을 동시에 진행하는 환경이 만들어지고 있다.
이러한 변화는 단순히 코드 작성 속도에만 영향을 주는 것이 아니다.
코드가 생성되는 속도가 빨라지면 Git Branch, Commit, Push, Fetch, Merge, CI/CD 작업의 빈도도 함께 증가한다. 그리고 이러한 작업이 수천 개의 AI Agent 에 의해 동시에 수행된다면 기존 Source Control 인프라는 새로운 확장성 문제에 직면하게 된다.
2026년 11월 2일, OpenAI 는 공식 엔지니어링 블로그를 통해 이러한 문제를 해결하기 위해 개발한 새로운 Git 백엔드 시스템 Pando 를 공개했다.
Pando 는 Git 을 대체하는 새로운 Version Control System 이 아니다. 기존 Git Protocol 과 Client 의 호환성을 유지하면서, 대규모 동시 작업을 효율적으로 처리하도록 설계된 분산 Git 백엔드다.
OpenAI 에 따르면 Pando 도입 이후 Git Push 의 중앙값 지연시간은 약 80% 감소했고, 현재 하루 약 1PB 에 가까운 Git 데이터를 전송하고 있다.
이번 글에서는 OpenAI 가 왜 기존 Git 인프라를 재설계해야 했는지, Pando 의 내부 구조는 어떻게 동작하는지, 그리고 AI Agent 시대의 소프트웨어 개발 환경에 어떤 의미가 있는지 살펴보자.
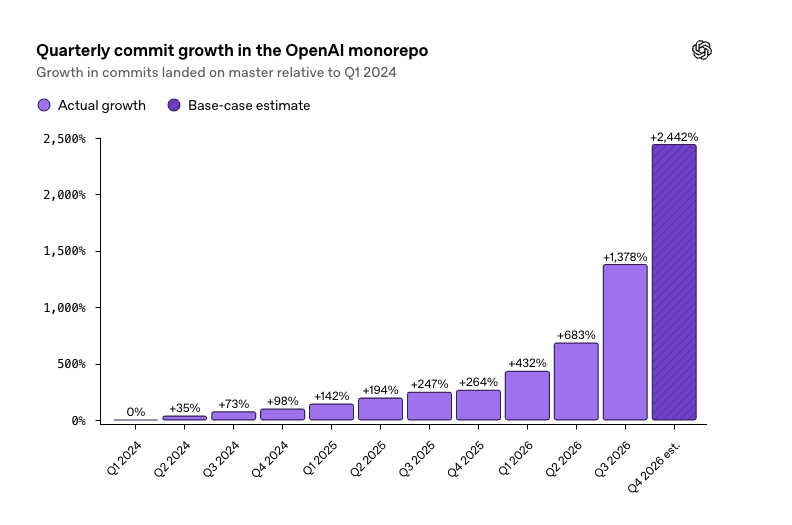
출처: OpenAI, Scaling Git at OpenAI (2026년 11월 2일)
1. AI Agent 가 Git 인프라에 가져온 변화
OpenAI 가 Pando 를 개발하게 된 직접적인 배경은 Codex 를 통한 개발 작업량의 급격한 증가였다.
기존 개발 환경에서는 한 명의 엔지니어가 한두 개의 기능을 개발하고, 변경 사항을 Push 한 뒤 CI 결과를 확인하는 작업 흐름이 일반적이었다.
하지만 AI Agent 를 활용하면 상황이 달라진다.
한 명의 개발자가 여러 Agent 에게 서로 다른 작업을 맡길 수 있다.
예를 들어 한 Agent 는 API 를 개발하고, 다른 Agent 는 테스트 코드를 작성하며, 또 다른 Agent 는 성능 개선 작업을 수행할 수 있다.
각 Agent 는 독립적인 Branch 를 생성하고 Commit 을 작성하며 Git Push 를 수행한다.
여기에 CI 시스템이 추가되면 각각의 Push 가 새로운 Fetch, Clone, 테스트 작업을 발생시킨다.
결과적으로 개발자 한 명이 만들어내는 Git 작업량이 이전보다 훨씬 커질 수 있다.
OpenAI 의 Monorepo 에서도 이러한 현상이 발생했다.
기존 인프라는 느린 Push 와 Fetch, Merge 실패 문제를 겪었고, 일부 시점에는 안정성이 90% 미만으로 떨어졌다.
여기서 중요한 질문이 등장한다.
Git 자체가 한계에 도달한 것일까? 아니면 Git Repository 를 제공하는 서버 아키텍처가 문제였을까?
OpenAI 는 후자에 주목했다.
Git 의 데이터 모델과 개발자들이 익숙하게 사용하는 명령어를 유지하면서, 서버 내부의 저장 및 동기화 방식을 새롭게 설계하는 방법을 선택한 것이다.
2. Git 은 내부적으로 데이터를 어떻게 저장할까?
Pando 의 구조를 이해하려면 먼저 Git 의 내부 데이터 모델을 이해할 필요가 있다.
Git Repository 는 크게 두 가지 요소로 구성된다.
Git Objects 와 References (Refs) 다.
Git Objects
Git 은 파일과 디렉터리, Commit History 를 객체 형태로 관리한다.
대표적으로 네 가지 객체가 있다.
Blob: 파일의 내용을 저장한다.
Tree: 디렉터리 구조와 파일 이름을 관리한다.
Commit: 특정 시점의 Tree 와 이전 Commit 정보를 참조한다.
Tag: 특정 객체를 가리키는 태그 정보를 저장한다.
이러한 객체들은 Hash 를 기반으로 식별되며, 한 번 생성된 객체의 내용은 변경되지 않는다.
예를 들어 기존 파일을 수정하면 기존 Blob 을 직접 변경하는 것이 아니라 새로운 Blob 객체가 만들어진다.
변경되지 않은 파일이나 디렉터리는 기존 객체를 재사용할 수 있다.
이러한 Immutable Object 모델은 Git 의 핵심 설계 원칙 중 하나다.
References (Refs)
반면 Branch 와 Tag 는 특정 Commit 을 가리키는 Reference 로 관리된다.
예를 들어 refs/heads/main 은 현재 main Branch 의 Commit 을 가리킨다.
새로운 Commit 을 Push 하면 Git 서버는 필요한 객체들을 저장한 뒤 해당 Branch 의 Reference 를 새로운 Commit 으로 변경한다.
따라서 분산 Git 서버를 구축할 때는 두 가지를 모두 고려해야 한다.
첫째, 새로운 Commit 을 구성하는 객체들이 저장되고 접근 가능해야 한다.
둘째, Branch Reference 의 변경이 올바른 순서로 처리되어야 한다.
이 두 가지 조건을 여러 서버에서 동시에 만족시키는 것이 분산 Git 시스템의 핵심 과제다.
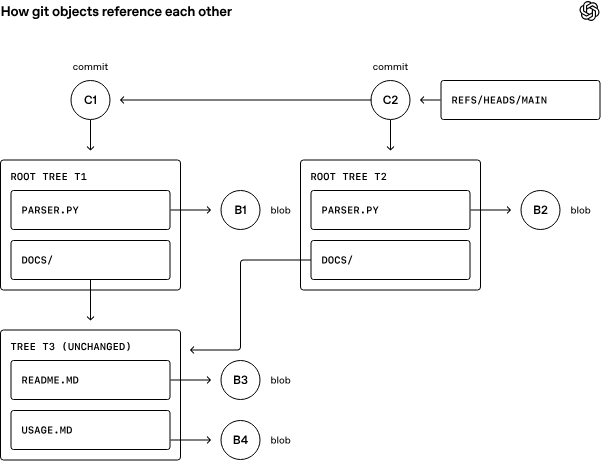
그림 설명: Commit, Tree, Blob 객체 사이의 참조 관계와 변경되지 않은 객체의 재사용 구조.
3. 기존 분산 Git 아키텍처의 한계
OpenAI 는 Pando 를 설계하면서 기존 분산 Git 시스템에서 사용할 수 있는 여러 접근 방식을 검토했다.
대표적인 방식으로 Three-Phase Commit (3PC) 과 Write-Ahead Log (WAL) 기반 구조를 분석했다.
3.1 Three-Phase Commit (3PC)
3PC 기반 설계에서는 여러 Git 서버가 Repository 의 전체 복제본을 유지한다.
Client 가 Push 하면 새로운 Packfile 을 여러 Replica 에 전달하고, 다수의 Replica 가 Reference 업데이트를 승인한 뒤 변경 사항을 확정한다.
이 방식은 여러 Replica 사이에서 일관된 Repository 상태를 유지하는 데 유리하다.
하지만 단점도 있다.
Push 작업마다 여러 서버 사이의 통신이 필요하고, Reference 변경을 조정하는 과정에서 지연이 발생한다.
특히 서로 관련 없는 Branch 에 대한 Push 도 전체 Repository 의 일관성을 유지하는 과정에서 영향을 받을 수 있다.
동시 작업량이 증가할수록 Replica 의 디스크 성능과 네트워크 지연이 중요한 병목이 된다.
3.2 Write-Ahead Log (WAL)
WAL 기반 설계는 변경 사항을 공통 로그에 기록하는 방식이다.
Push 가 발생하면 Packfile 을 Blob Storage 에 업로드하고, Reference 변경 정보를 공유 Manifest 에 기록한다.
Manifest 업데이트에는 Compare-And-Swap (CAS) 같은 원자적 연산을 사용할 수 있다.
이 방식에서는 Packfile 업로드 자체를 병렬로 처리할 수 있다.
그러나 모든 변경 사항이 하나의 공유 Manifest 를 업데이트해야 한다면 새로운 병목이 발생한다.
서로 다른 Branch 에 대한 Push 도 동일한 Manifest 를 수정하기 위해 경쟁하게 되는 것이다.
또한 Git 서버가 새로운 Packfile 을 다운로드하고 인덱싱하는 속도보다 Push 가 빠르게 발생하면 Replica 가 최신 상태를 따라가지 못할 수 있다.
OpenAI 는 이러한 방식이 AI Agent 가 만들어내는 대규모 병렬 작업을 처리하는 데 한계가 있다고 판단했다.
4. Pando 의 핵심 설계: Repository 전체가 아닌 Branch 단위의 일관성
Pando 가 기존 분산 Git 시스템과 구별되는 가장 중요한 특징은 Consistency Model 에 있다.
일반적인 분산 Git 시스템은 Repository 전체의 Reference 에 대해 일관된 상태를 제공하려고 한다.
하지만 Pando 는 이러한 요구사항을 완화했다.
대신 Causal Consistency 를 활용해 Branch 별 업데이트를 독립적으로 처리한다.
Repository-Wide Consistency 와 Causal Consistency
예를 들어 feature/login 과 feature/payment 라는 두 Branch 가 있다고 가정해 보자.
두 Branch 는 서로 다른 기능을 개발하고 있으므로 변경 사항 사이에 직접적인 의존성이 없을 수 있다.
그런데 모든 Reference 변경을 하나의 전역 순서로 처리한다면, 두 Branch 의 Push 가 불필요하게 서로를 기다릴 수 있다.
Pando 는 이러한 문제를 줄이기 위해 서로 다른 Reference 에 대한 업데이트를 병렬로 처리한다.
동일한 Reference 에 대해서는 원자적인 업데이트를 보장하지만, 서로 다른 Reference 들이 Repository 전체에서 동일한 시점의 상태로 관찰되어야 한다고 요구하지 않는다.
예를 들어 한 Client 가 feature/login 의 최신 상태와 feature/payment 의 이전 상태를 동시에 관찰할 수 있다.
다른 Client 는 반대 조합을 관찰할 수도 있다.
이것은 의도된 설계상의 Trade-off 다.
대부분의 개발 작업에서는 Repository 전체 Branch 의 정확한 동시 상태보다, 자신이 작업하는 Branch 의 변경 이력이 올바르게 유지되는 것이 더 중요하기 때문이다.
물론 이러한 설계가 모든 Git 사용 사례에 적합하다는 의미는 아니다.
여러 Branch 를 하나의 일관된 Snapshot 으로 관찰해야 하는 시스템이라면 별도의 고려가 필요하다.
하지만 OpenAI 의 개발 환경에서는 이러한 제약을 완화함으로써 높은 병렬 처리 성능을 얻을 수 있었다.
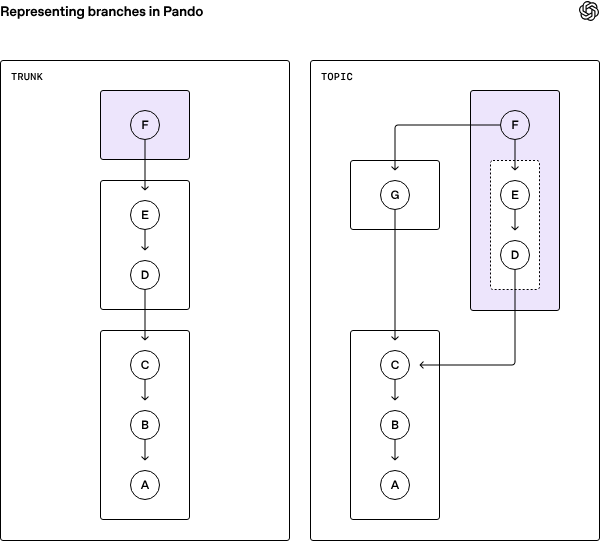
그림 설명: Pando, 3PC, WAL 방식의 동시 Push 처리와 Push-to-Fetch Latency 비교.
원문에는 Client 수와 인프라 성능을 변경하며 비교할 수 있는 인터랙티브 시뮬레이션이 제공된다.
5. Pando 의 내부 아키텍처
Pando 는 크게 다음과 같은 구성 요소를 활용한다.
Blob Storage, Metadata Store, Pando Server, Express Cache, Background Compaction Workers 다.
이 구성 요소들이 Push 와 Fetch 작업을 서로 다른 방식으로 처리한다.
5.1 Push: Packfile 을 그대로 저장한다
기존 Git 서버는 Client 로부터 Packfile 을 받은 뒤 Repository 에 반영하고, 객체를 관리하며, 필요에 따라 재구성하는 작업을 수행한다.
Pando 는 다른 접근 방식을 사용한다.
Client 가 git push 를 수행하면 Pando 는 전달받은 Packfile 을 검증하면서 Blob Storage 로 스트리밍한다.
이 과정에서 Packfile 전체를 로컬 Repository 에 풀어 저장할 필요가 없다.
Packfile 은 Immutable Blob 으로 저장된다.
그리고 Metadata Store 에 새로운 Reference Version 을 기록한다.
Reference Version 에는 다음과 같은 정보가 포함된다.
새로운 Commit 을 가리키는 Reference 정보
해당 변경 사항을 포함하는 Packfile
Packfile 이 의존하는 이전 Reference Version
이후 Metadata Store 의 원자적 트랜잭션을 통해 Reference Pointer 를 갱신한다.
이 과정은 동일한 Reference 에 대한 충돌을 제어하면서, 다른 Reference 에 대한 Push 는 병렬로 처리할 수 있게 한다.
OpenAI 에 따르면 동기식 Push 경로에서 필요한 Metadata 읽기 및 쓰기는 O(1) 수준으로 설계됐다.
이는 Repository 전체 크기가 증가하더라도 핵심 Metadata 처리 비용을 일정하게 유지하려는 접근이다.
5.2 Fetch: 새로운 Packfile 을 만들지 않고 기존 Packfile 을 재사용한다
Pando 의 또 다른 핵심 최적화는 Fetch 처리 방식이다.
일반적인 Git 서버는 Client 가 보유한 Commit 과 필요한 Commit 을 비교한 뒤 전송할 객체들을 계산하고, Client 에 맞는 Packfile 을 생성한다.
하지만 Client 가 많아지면 이 과정에서 CPU 와 Disk I/O 사용량이 크게 증가할 수 있다.
Pando 는 Push 과정에서 저장한 Packfile 을 재사용한다.
Client 가 Fetch 를 요청하면 서버는 Client 가 보유한 Commit 과 필요한 Commit 을 분석하고, 어떤 Packfile 들을 전달해야 하는지 결정한다.
그런 다음 필요한 Packfile 의 URI 를 Client 에 전달한다.
실제 데이터 전송은 별도의 서비스인 Express 를 통해 이루어진다.
즉, Pando Server 는 주로 Git Protocol 협상과 Packfile 선택을 담당하고, 대용량 데이터 전송은 Cache 기반 서비스로 분리하는 것이다.
이렇게 하면 동일한 Packfile 을 여러 Client 에게 제공할 수 있고, Client 별로 Packfile 을 다시 생성하는 비용을 줄일 수 있다.
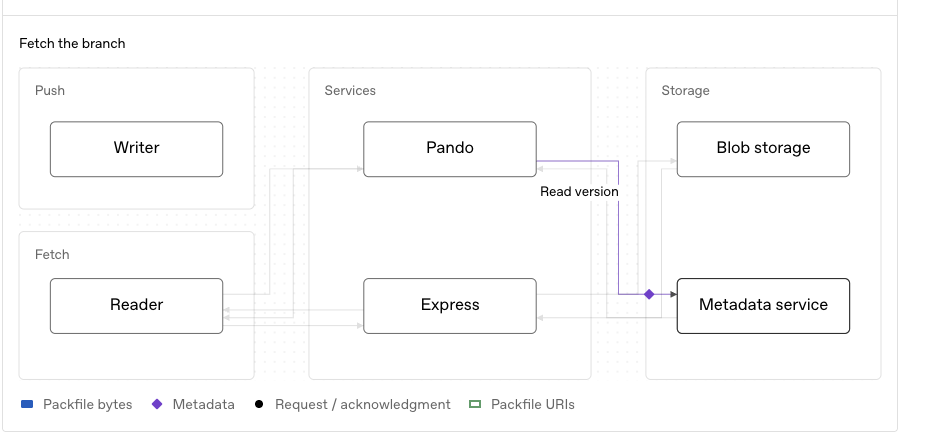
그림 설명: Client 의 Push, Blob Storage, Turtle Metadata Store, Express Cache 를 거치는 Fetch 데이터 흐름.
5.3 Packfile URI 와 Git Protocol 호환성
여기서 흥미로운 기술이 등장한다.
바로 Git Protocol 의 packfile-uri 기능이다.
일반적인 Git Fetch 에서는 서버가 Packfile 데이터를 응답으로 전달한다.
하지만 packfile-uri 를 활용하면 서버가 추가 Packfile 을 다운로드할 수 있는 URI 를 Client 에 제공할 수 있다.
Pando 는 이 기능을 적극적으로 사용한다.
Git Protocol 응답에는 빈 Packfile 을 포함하고, 실제 필요한 Packfile 은 별도 URI 를 통해 다운로드하도록 구성한다.
이 방식은 대용량 데이터를 지역별 Cache 에서 전달하기에 유리하다.
OpenAI 는 이 기능을 개선하기 위해 Git 오픈소스 프로젝트에도 여러 변경 사항을 기여했다.
따라서 Pando 는 Git 을 버리는 접근이 아니라, Git Protocol 을 활용하고 확장하는 접근에 가깝다.
5.4 Express: 지역별 Cache 를 활용한 대용량 데이터 전송
OpenAI 의 개발 및 연구 환경은 여러 지역에 분산되어 있다.
따라서 Git 데이터를 중앙 서버에서만 전달하면 네트워크 지연과 대역폭 문제가 발생할 수 있다.
Pando 는 지역별 Cache 를 활용한다.
Express 는 Blob Storage 에 저장된 Packfile 을 Cache 에 보관하고 Client 에 전달하는 역할을 수행한다.
OpenAI 에 따르면 Express 의 Cache Hit Rate 는 99% 이상이다.
또한 일반적인 Cloud Provider 의 VM 을 활용한 환경에서 Clone 과 Fetch 작업이 10Gbps 네트워크 링크의 대역폭을 포화시킬 수 있음을 검증했다.
이는 Git 데이터를 제공하는 서버가 매번 복잡한 Packfile 생성 작업을 수행하지 않아도 된다는 의미다.
결과적으로 계산 작업과 데이터 전송을 분리함으로써 각각을 독립적으로 확장할 수 있게 된다.
6. Compaction: 수많은 Packfile 을 어떻게 관리할까?
Pando 가 Push 할 때마다 새로운 Packfile 을 저장한다면 시간이 지날수록 Packfile 의 개수가 계속 증가할 것이다.
예를 들어 Client 가 며칠 동안 Fetch 하지 않았다면 그동안 생성된 수많은 Packfile 을 다운로드해야 할 수 있다.
이는 네트워크 요청 수와 Fetch Latency 를 증가시키는 원인이 된다.
Pando 는 이러한 문제를 해결하기 위해 Background Compaction 을 사용한다.
이 방식은 Log-Structured Merge Tree (LSM Tree) 의 설계와 유사하다.
새로운 Push 가 발생하면 가장 작은 단위인 L0 Packfile 이 생성된다.
이후 Background Worker 가 여러 Packfile 을 묶어 더 큰 Cover 를 구성한다.
Pando 는 L0, L1, L2 등 여러 레벨의 Cover 를 활용하며, OpenAI 의 Monorepo 에서는 L4 까지 사용하고 있다.
Cover 는 단순히 Packfile 을 압축하는 용도만 있는 것이 아니다.
여러 Reference Version 을 효율적으로 탐색할 수 있는 구조를 제공한다.
그 결과 Client 가 보유한 Version 과 필요한 Version 사이의 차이를 계산할 때 모든 Packfile 을 순차적으로 확인할 필요가 줄어든다.
OpenAI 는 Fetch Planning 의 Metadata 조회 비용을 O(log Δ) 수준으로 설명한다.
여기서 Δ 는 Client 가 보유한 Reference Version 과 필요한 Version 사이의 최단 거리다.
즉, Client 가 오랫동안 업데이트하지 않았더라도 필요한 Packfile 을 효율적으로 선택할 수 있도록 설계한 것이다.
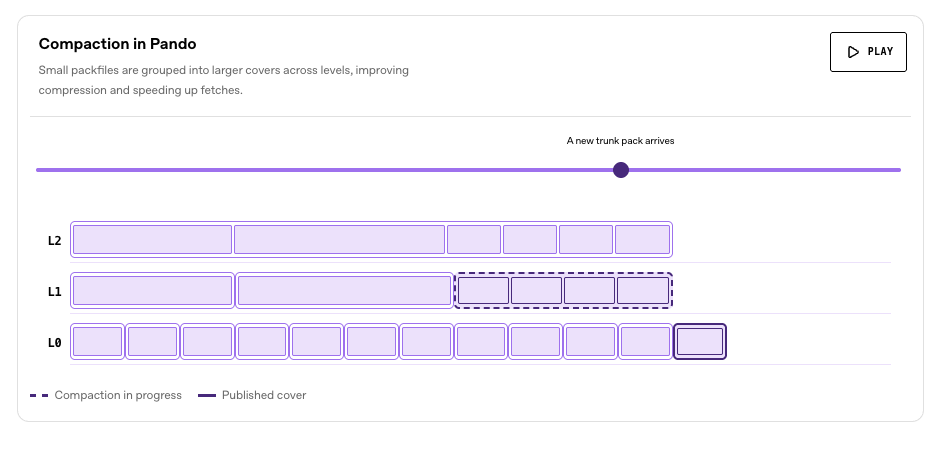
그림 설명: L0 Packfile 이 상위 레벨의 Cover 로 묶이고, Background Compaction 을 통해 Fetch 효율이 개선되는 과정.
7. 실제 운영 환경에서 확인된 성능
OpenAI 가 공개한 운영 성능은 상당히 인상적이다.
Git Push 지연시간 약 80% 감소
Pando 도입 이후 Median Push Latency 가 약 80% 감소했다.
이를 속도 관점에서 표현하면 기존 대비 약 5배 수준의 개선이다.
다만 모든 Push 가 동일하게 5배 빨라졌다는 의미는 아니다. 공개된 수치는 중앙값 지연시간을 기준으로 한다.
하루 약 1PB 규모의 Git 데이터 전송
Pando 는 하루 약 1PB 에 가까운 Git 데이터를 전달하고 있다.
또한 한 시간 동안 57TB 이상의 Git Packfile 데이터를 제공한 사례도 공개했다.
이 데이터의 99% 이상은 로컬 디스크 Cache 에서 제공됐다.
이러한 결과는 Packfile 재사용과 Cache 중심의 아키텍처가 대규모 Fetch 작업에서 효과적이라는 점을 보여준다.
Merge Reliability 개선
OpenAI 는 Pando 도입으로 Merge Reliability 역시 개선됐다고 설명했다.
기존 시스템에서 발생하던 병목과 실패를 줄이면서 대규모 병렬 개발 작업을 보다 안정적으로 처리할 수 있게 된 것이다.
8. Pando 는 어떻게 단 10주 만에 개발됐을까?
이번 기술 블로그에서 또 하나 흥미로운 부분은 Pando 의 개발 과정이다.
OpenAI 에 따르면 Pando 는 프로젝트 시작부터 Production 배포까지 약 10주가 걸렸다.
핵심 설계는 한 명의 엔지니어가 주도했고, 구현 과정에는 여러 AI Agent 팀이 참여했으며, 실제 배포는 소수의 엔지니어들이 담당했다.
개발 언어로는 Rust 를 선택했다.
새로운 프로젝트였기 때문에 기존 시스템의 Legacy Dependency 를 최소화하면서 설계를 진행할 수 있었다.
그러나 AI Agent 가 대규모 시스템 코드를 생성하는 과정에서는 코드의 정확성과 안정성을 검증하는 것이 중요하다.
OpenAI 는 이를 위해 여러 검증 방법을 활용했다.
Git Conformance Testing
Pando 가 표준 Git 동작과 호환되는지 확인하기 위한 테스트를 구축했다.
이는 새로운 백엔드를 도입하더라도 기존 Git Client 와 개발 도구가 예상대로 동작하도록 검증하는 과정이다.
Deterministic Simulation Testing
분산 시스템에서는 Race Condition 과 동시성 문제가 발생하기 쉽다.
특히 여러 Client 가 동일한 Branch 를 동시에 수정하거나, Push 와 Fetch 가 겹치는 상황에서는 미묘한 오류가 발생할 수 있다.
OpenAI 는 재현 가능한 시뮬레이션 테스트를 통해 시스템의 Invariant 와 동작 특성을 검증했다.
Formal Verification
OpenAI 는 GPT-6 Astra 기반 Agent 를 활용해 Lean 과 TLA+ 로 Pando 의 동작을 형식적으로 모델링했다고 밝혔다.
Lean 은 정리 증명에 활용할 수 있는 도구이고, TLA+ 는 분산 시스템의 상태 전이와 불변 조건을 명세하고 검증하는 데 사용된다.
이러한 도구를 통해 구현에서 발생할 수 있는 오류를 발견하고 시스템의 성질을 검증했다.
또한 여러 Agent 세션이 수백 시간 동안 실행되면서 Edge Case 와 오류를 찾아 수정했다고 설명했다.
이는 AI Agent 가 단순한 코드 생성뿐 아니라 테스트, 검증, 성능 개선 과정에도 활용될 수 있음을 보여주는 사례다.
다만 핵심 아키텍처 설계와 운영상의 책임까지 AI 가 독립적으로 수행했다는 의미는 아니다.
Pando 는 인간 엔지니어의 설계와 판단을 중심으로 AI Agent 를 적극적으로 활용한 개발 사례라고 볼 수 있다.
9. 기존 시스템에서 Pando 로 어떻게 이전했을까?
새로운 Git 백엔드를 개발하는 것만큼 어려운 문제는 기존 개발 환경을 중단하지 않고 이전하는 것이다.
OpenAI 는 처음부터 기존 시스템을 한 번에 교체하지 않았다.
대신 Pando 를 기존 Source Control 시스템 앞에 배치하는 Read-Through 및 Write-Through Proxy 방식으로 시작했다.
이 구조에서는 Pando 와 기존 백엔드를 동기화하면서 트래픽을 점진적으로 이전할 수 있다.
또한 중복 요청을 합치거나 Cache 를 활용해 기존 시스템의 부하를 줄일 수 있었다.
이후 Git Client 와 개발 도구, CI 시스템, 자동화 도구를 단계적으로 이전했다.
OpenAI 는 내부 Git CLI Wrapper 를 활용해 Client 의 이전 과정을 관리했으며, 수백 개의 Legacy API, Webhook, Repository 다운로드 관련 Integration 도 함께 이전했다.
흥미롭게도 Codex 자체가 이 이전 과정에도 활용됐다.
개발자들은 Codex 에게 개발 환경이나 서비스의 이전 작업을 요청할 수 있도록 관련 Skill 을 제공받았다.
즉, AI Agent 의 확산으로 발생한 인프라 문제를 해결하는 과정에서도 AI Agent 를 활용한 것이다.
10. OpenAI 는 GitHub 와 Git 을 떠나는 것일까?
이번 발표를 보면 OpenAI 가 GitHub 를 완전히 버리는 것처럼 이해할 수도 있다.
그러나 정확히 구분할 필요가 있다.
Git 은 분산 버전 관리 시스템이고, GitHub 는 Git Repository 호스팅과 협업 기능을 제공하는 플랫폼이다.
OpenAI 가 Pando 를 개발한 목적은 Git 자체를 폐기하는 것이 아니다.
오히려 기존 Git Protocol 과 Client 의 호환성을 유지하는 것이 중요한 설계 목표였다.
Pando 는 현재 OpenAI 의 Monorepo 개발 작업을 지원하는 자체 Git 백엔드로 운영되고 있다.
따라서 이번 발표는 OpenAI 가 대규모 Source Control 작업을 위해 기존 백엔드 의존도를 줄이고 자체 인프라를 구축했다는 의미로 이해하는 것이 정확하다.
GitHub 의 모든 기능과 서비스를 대체했다거나, GitHub 와의 관계를 완전히 종료했다는 의미로 해석해서는 안 된다.
오히려 OpenAI 는 Pando 를 개발하면서 발견한 Git Client 개선 사항을 오픈소스 Git 프로젝트에 기여하고 있다.
일부 개선 사항은 이미 Upstream Git 에 반영됐으며, 다른 변경 사항도 공개 저장소를 통해 공유하고 있다.
11. AI Agent 시대의 개발 인프라는 어떻게 달라질까?
Pando 의 등장은 단순한 Git 서버 성능 개선 사례 이상의 의미를 가진다.
지금까지 많은 개발 도구는 사람이 중심이 되는 작업 흐름을 기준으로 설계됐다.
개발자가 코드를 작성하고, Commit 을 생성하고, Pull Request 를 열고, CI 결과를 확인하는 과정이다.
하지만 AI Agent 가 개발 작업에 적극적으로 참여하면 기존의 가정이 달라진다.
한 명의 개발자가 여러 Agent 를 실행할 수 있고, 각각의 Agent 는 독립적으로 코드를 생성하고 테스트할 수 있다.
이 과정에서 Repository, CI/CD, Artifact Storage, Code Review, 보안 검증 시스템까지 더 높은 동시성과 처리량을 요구받게 된다.
특히 다음과 같은 변화가 중요해질 수 있다.
첫째, Source Control 시스템의 병렬 처리 능력이다.
서로 관련 없는 Branch 에 대한 작업이 불필요하게 경쟁하지 않도록 설계해야 한다.
둘째, 데이터 전송과 계산 작업의 분리다.
Pando 처럼 Packfile 을 재사용하고 Cache 에서 데이터를 제공하는 방식은 대규모 읽기 요청을 처리하는 데 유리하다.
셋째, Consistency Model 에 대한 재검토다.
모든 데이터에 강한 일관성이 필요한 것은 아니다.
업무 요구사항에 따라 적절한 일관성 수준을 선택하면 더 높은 확장성을 얻을 수 있다.
넷째, AI Agent 를 고려한 개발 도구의 설계다.
앞으로는 사람뿐 아니라 AI Agent 가 Repository 와 CI/CD 시스템을 사용하는 주요 Client 가 될 수 있다.
다섯째, 검증과 안정성의 중요성이다.
AI 가 더 많은 코드를 생성할수록 테스트, 보안, 시스템 설계, 장애 대응의 중요성도 커질 수 있다.
Pando 개발 과정에서 Formal Verification 과 Deterministic Simulation Testing 을 적극적으로 활용한 점은 이러한 변화를 잘 보여준다.
마치며: AI 가 코드를 만드는 시대를 넘어, 개발 인프라까지 바꾸고 있다
OpenAI 의 Pando 는 AI Agent 가 만들어낸 새로운 개발 환경에 대응하기 위해 구축된 분산 Git 백엔드다.
핵심은 Git 을 버리는 것이 아니라, Git 의 데이터 모델과 기존 개발 경험을 유지하면서 서버 아키텍처를 새롭게 설계했다는 데 있다.
Repository 전체의 강한 일관성을 완화하고, Branch 단위의 독립적인 업데이트를 지원하며, Packfile 재사용과 지역별 Cache 를 통해 대규모 Fetch 작업을 효율적으로 처리한다.
또한 Pando 자체를 개발하는 과정에서 Codex 와 여러 AI Agent 를 적극적으로 활용했다는 점도 주목할 만하다.
앞으로 AI Agent 가 개발 과정에서 차지하는 비중이 더욱 커진다면, 이러한 변화는 Source Control 시스템에만 머물지 않을 가능성이 있다.
CI/CD, Code Review, Testing, Security, Deployment 등 소프트웨어 개발 인프라 전반에서 새로운 확장성 요구사항이 등장할 수 있다.
그리고 이러한 변화는 개발자의 역할에도 영향을 줄 것이다.
단순히 코드를 작성하는 능력을 넘어, AI Agent 가 만들어내는 대규모 작업을 안정적으로 관리하고 검증할 수 있는 시스템 설계 역량이 더욱 중요해질 수 있기 때문이다.
AI 가 소프트웨어를 개발하는 시대에, 우리는 어떤 개발 인프라를 준비해야 할까?
KAITA 커뮤니티에서도 개발자, DevOps 엔지니어, AI 엔지니어, Solutions Architect 등 다양한 분야의 전문가들이 함께 논의해 볼 만한 주제다.
참고 자료
OpenAI Engineering — Scaling Git at OpenAI
발행일: 2026년 11월 2일
저자: Aaron Friel, Taylor Blau, Ted Nyman
https://openai.com/index/scaling-git-at-openai/
※ 본 글은 OpenAI 의 공식 기술 블로그를 바탕으로 핵심 내용을 한국어로 재구성하고, Git 및 분산 시스템 관점의 기술적 설명을 추가한 글이다. 일부 예시는 이해를 돕기 위한 가상 시나리오다.
댓글 0
로그인하고 댓글 남기기 →