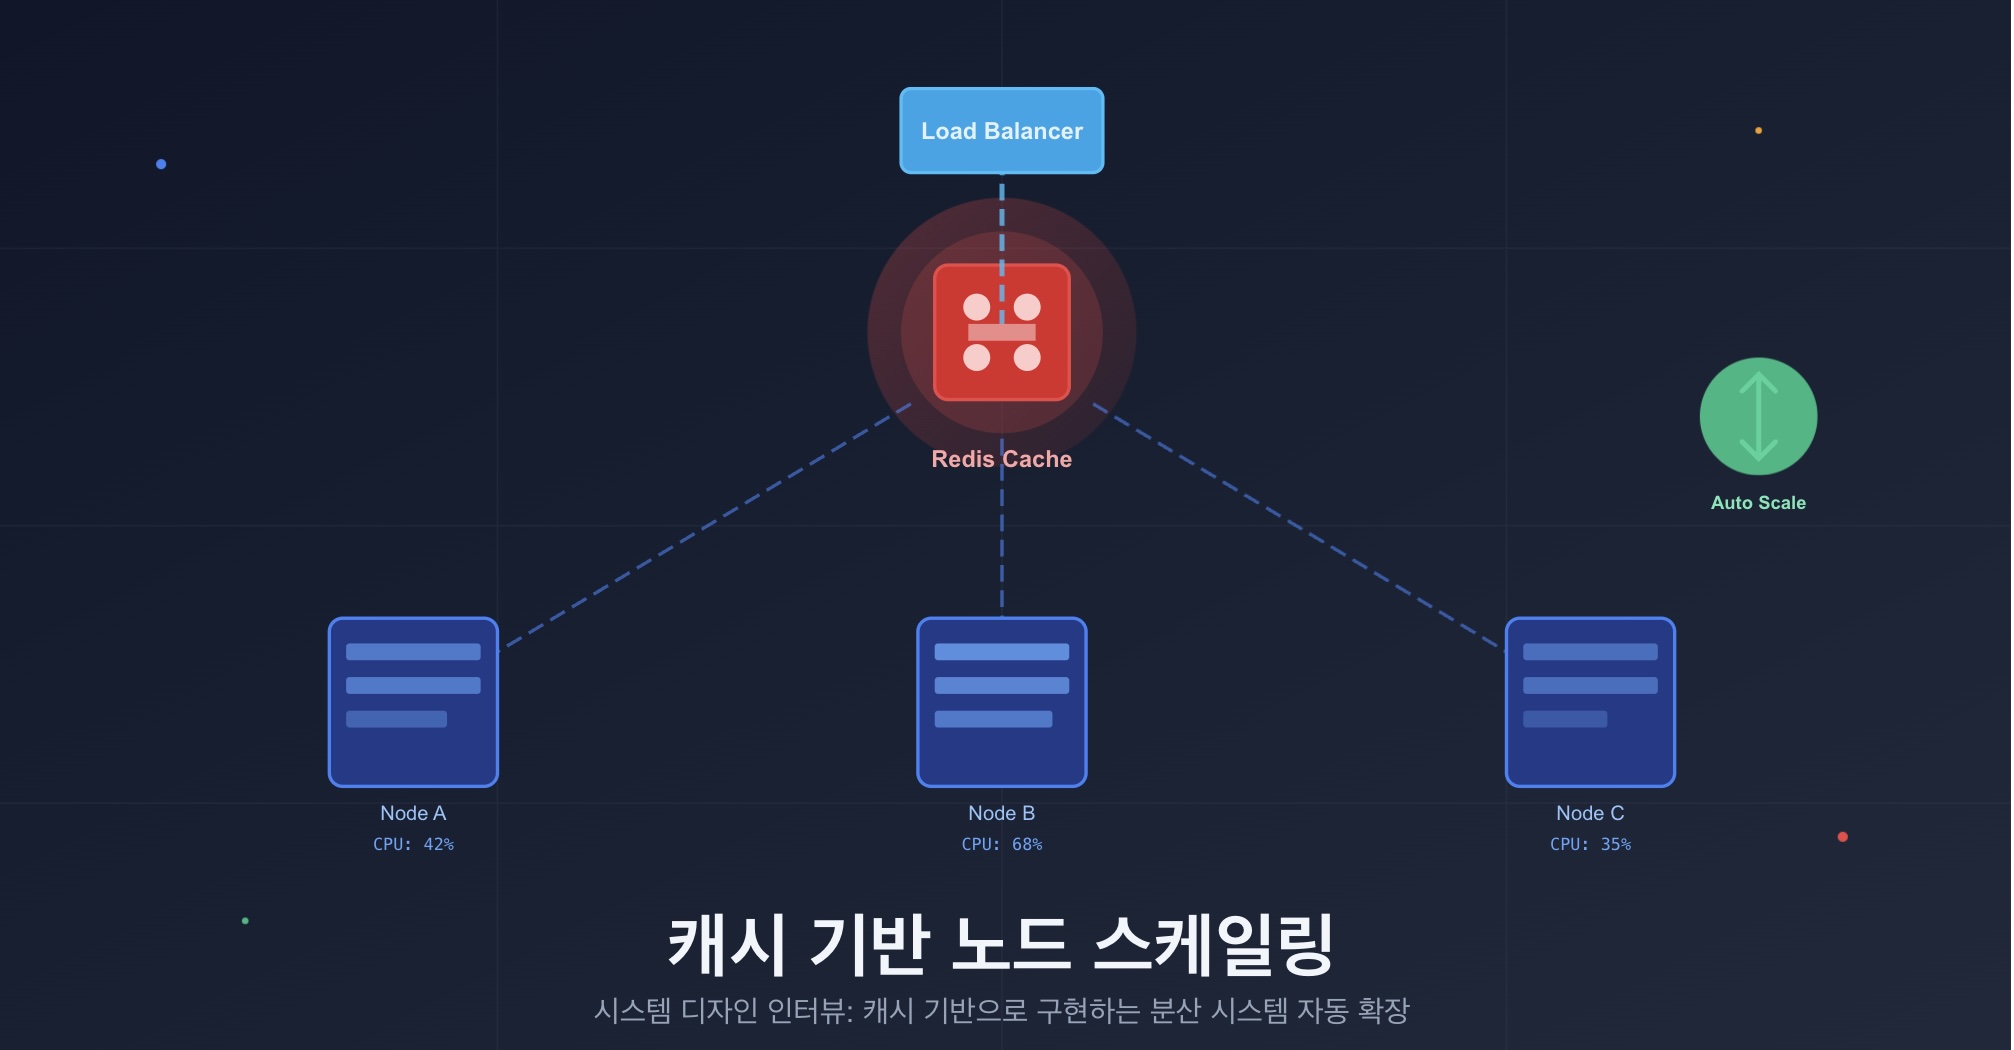
시스템 디자인 인터뷰: 캐시를 활용한 노드 스케일링 구현 가이드
#시스템디자인#인터뷰
46 0
대규모 트래픽을 처리하는 분산 시스템에서는 각 노드의 상태를 실시간으로 파악하고 자동으로 스케일링하는 메커니즘이 필수적입니다. 이 글에서는 캐시를 단순한 데이터 저장소가 아닌 클러스터 상태 관리 시스템으로 활용하는 방법을 소개합니다.
주의: 로컬 캐시는 해당 노드의 응답 속도만 개선하며, 노드 선택 로직과는 무관합니다.
1.캐시를 "클러스터 레지스트리"로 활용하기
Redis와 같은 인메모리 데이터 저장소를 사용하면 각 노드의 상태를 중앙에서 관리할 수 있습니다. 로드 밸런서나 오토스케일러는 이 정보를 기반으로 트래픽 분산과 스케일링 결정을 내립니다.
노드가 캐시에 기록하는 정보각 노드는 주기적으로 다음 메트릭을 캐시에 저장합니다:
- 노드 ID: 고유 식별자
- 상태: healthy / unhealthy / degraded
- 현재 로드: CPU 사용률, 메모리 사용량
- 처리 중인 요청 수: Active connections
- 마지막 heartbeat 시간: 노드 생존 확인
구현 예시 - JAVASCRIPT:
// Node가 상태를 Redis에 등록const nodeStatus = { nodeId: "node-a-us-east-1", status: "healthy", cpuUsage: 0.42, memoryUsage: 0.58, activeRequests: 103, lastHeartbeat: Date.now()};await redis.setex( `cluster:nodes:${nodeStatus.nodeId}`, 10, // TTL 10초 JSON.stringify(nodeStatus));TTL 기반 자동 정리: 10초 내에 heartbeat가 갱신되지 않으면 해당 노드는 자동으로 제거됩니다.
효과
- 빠른 의사결정: 로드 밸런서가 실시간 노드 상태를 즉시 확인
- 자동 장애 감지: 다운된 노드를 TTL 만료로 자동 제외
- 서비스 디스커버리: Consul이나 etcd와 유사한 역할 수행
2. 로컬 캐시는 노드 내부 성능 최적화용각
노드 내부에서는 LRU(Least Recently Used) 캐시를 사용하여 빈번한 조회 성능을 개선합니다.
예: python
from functools import lru_cache@lru_cache(maxsize=1000)def get_user_profile(user_id): # 데이터베이스 조회를 캐싱 return db.query(f"SELECT * FROM users WHERE id={user_id}")3. 스케일링 결정 기준
캐시에 저장된 모든 노드의 메트릭을 집계하여 클러스터 전체 상태를 파악합니다.
스케일 아웃(노드 추가) 조건
예: javascript
// 모든 노드의 평균 CPU 계산const nodes = await redis.keys('cluster:nodes:*');const metrics = await Promise.all( nodes.map(key => redis.get(key)));const avgCPU = metrics.reduce((sum, m) => sum + JSON.parse(m).cpuUsage, 0) / metrics.length;if (avgCPU > 0.70) { // 새 노드 추가 트리거 autoscaler.scaleOut();}
트리거 조건:
- 평균 CPU > 70% (5분 이상 지속)
- Active requests > 임계값 (예: 노드당 500개 초과)
- P95 응답 시간 > 500ms
- 노드 장애 발생 (Heartbeat 미갱신)
스케일 인(노드 축소) 조건
- CPU < 40% (15분 이상 유지)
- Active requests < 노드 용량의 30%
- 야간 트래픽 감소 패턴 감지
javascript
// 모든 노드의 평균 CPU 계산const nodes = await redis.keys('cluster:nodes:*');const metrics = await Promise.all( nodes.map(key => redis.get(key)));const avgCPU = metrics.reduce((sum, m) => sum + JSON.parse(m).cpuUsage, 0) / metrics.length;if (avgCPU > 0.70) { // 새 노드 추가 트리거 autoscaler.scaleOut();}```**트리거 조건:**- 평균 CPU > 70% (5분 이상 지속)- Active requests > 임계값 (예: 노드당 500개 초과)- P95 응답 시간 > 500ms- 노드 장애 발생 (Heartbeat 미갱신)### 📉 스케일 인(노드 축소) 조건- CPU < 40% (15분 이상 유지)- Active requests < 노드 용량의 30%- 야간 트래픽 감소 패턴 감지전체 아키텍처 [Load Balancer / Nginx] | v [Shared Cache - Redis Cluster] (노드 상태, 로드, TTL 저장) | +----------------+----------------+ | | | [Node A] [Node B] [Node C] (Heartbeat) (Heartbeat) (Heartbeat) 로컬 LRU 캐시 로컬 LRU 캐시 로컬 LRU 캐시 | | | +----------------+----------------+ | [데이터베이스]
주요 컴포넌트 역할
| 컴포넌트 | 역할 | 기술 스택 예시 |
|---|---|---|
| Load Balancer | 트래픽 분산 | Nginx, HAProxy, AWS ALB |
| Shared Cache | 클러스터 상태 저장 | Redis, etcd, Consul |
| Autoscaler | 스케일링 결정 | Kubernetes HPA, AWS Auto Scaling |
| Local Cache | 노드 성능 최적화 | LRU Cache, Guava Cache |
실전 구현 가이드
Kubernetes에서 HPA와 Redis 연동
Kubernetes에서 HPA와 Redis 연동
예: yaml
apiVersion: autoscaling/v2kind: HorizontalPodAutoscalermetadata: name: app-hpaspec: scaleTargetRef: apiVersion: apps/v1 kind: Deployment name: app-deployment minReplicas: 3 maxReplicas: 10 metrics: - type: External external: metric: name: redis_avg_cpu_usage target: type: AverageValue averageValue: "70"AWS에서 CloudWatch + Lambda 활용
Lambda 함수가 주기적으로 Redis 메트릭을 확인하고 Auto Scaling Group을 조정합니다.
예: python
import boto3import redisdef lambda_handler(event, context): r = redis.Redis(host='cache.example.com') nodes = r.keys('cluster:nodes:*') avg_cpu = calculate_avg_cpu(nodes) if avg_cpu > 0.70: autoscaling = boto3.client('autoscaling') autoscaling.set_desired_capacity( AutoScalingGroupName='my-asg', DesiredCapacity=current_capacity + 2 )
핵심 인사이트
캐시는 단순한 성능 최적화 도구를 넘어 분산 시스템의 제어 평면(Control Plane) 역할을 수행할 수 있습니다:
- 실시간 상태 공유: 모든 노드의 현재 상태를 밀리초 단위로 파악
- 분산 의사결정: 중앙 집중식 모니터링 없이도 자율적 스케일링
- 장애 격리: TTL 기반으로 문제 노드를 자동 제거
- 비용 최적화: 트래픽 패턴에 따라 리소스를 동적으로 조정
결론
이 아키텍처는 다음과 같은 시나리오에 적합합니다:
- 마이크로서비스 환경: 수십~수백 개의 서비스 인스턴스 관리
- 이벤트 기반 트래픽: 특정 시간대에 급격한 부하 증가 (예: 이커머스 플래시 세일)
- 글로벌 분산 시스템: 여러 리전에 걸친 노드 조정
- 비용 최적화: 클라우드 환경에서 유휴 리소스 최소화
댓글 0
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.